
Cinque modelli di trading competono sul Nasdaq-100. La regola per vincere è stata scritta prima della gara.
Panoramica.
Un modello sa scegliere swing trade migliori del caso?
Non “sa guadagnare in un mercato rialzista”, ma: le sue sette scelte battono sette titoli del Nasdaq presi a caso lo stesso giorno, con stessi stop, target e costi?
Ogni backtest sembra buono a chi lo ha scritto
Prova abbastanza varianti e una brillerà per fortuna. Così è costruita la maggior parte dell'AI per il trading, poi venduta con la sua curva migliore.
I modelli competono con regole fisse
Famiglie di modelli diverse affrontano gli stessi anni mai visti, lo stesso trade e una regola di vittoria scritta in anticipo. Il campione va in produzione su carta; il verdetto è stampato accanto ai segnali.
I modelli.
LightGBM
Alberi con gradient boosting su 31 variabili di prezzo, volume e mercato note alla chiusura: rendimenti da 1 a 120 giorni, volatilità, ATR, distanza dalle medie a 20, 50 e 200 giorni, RSI, gap, forza relativa contro QQQ, VIX e ranking trasversali.
LightGBM + utili
Gli stessi alberi più il drift post-utili: l'ultima sorpresa, i giorni dalla pubblicazione, la reazione del prezzo e la sua serie. Un report conta solo dal primo giorno in cui il mercato poteva negoziarlo.
LSTM
Una rete ricorrente sugli ultimi 20 giorni × 13 input di ogni titolo, addestrata con PyTorch sulla GPU M1 (Metal).
Transformer
Un encoder a due livelli con posizioni apprese sulla stessa sequenza di 20 giorni, così può confrontare qualsiasi giorno della finestra con qualsiasi altro.
Ensemble
La media dei ranghi percentili giornalieri dei quattro modelli, che elimina le loro diverse scale di punteggio.
Dal 2010 a oggi
Prezzi giornalieri di ogni ticker più QQQ e VIX, e lo storico degli utili di ogni azienda, aggiornati ogni settimana da Yahoo Finance e salvati in Parquet.
Le regole.
- 1Walk-forward, mai mescolatoOgni modello viene riaddestrato ogni anno solo sui dati precedenti e valutato sull'anno successivo, mai visto, dal 2019 al 2026. Un intervallo di purge di 12 giorni impedisce che un'etichetta di training si sovrapponga all'anno di test.
- 2Lo stesso trade per tuttiEntrata all'apertura successiva, stop a 1×ATR, target a 2×ATR, uscita al massimo dopo 5 giorni, meno lo 0,10% di costi andata e ritorno. Se in un giorno vengono toccati sia stop sia target, conta come stop.
- 3Una regola del campione scritta primaPrima di qualsiasi risultato: vince il modello le cui 7 scelte migliori battono la media di tutti i titoli con la t-statistica più alta, corretta per la sovrapposizione. È considerato dimostrato solo se t ≥ 2.
- 4Ogni tentativo viene contatoOgni configurazione mai testata è registrata in trials.json e lo Sharpe ratio viene corretto (deflated) per quel numero di tentativi (Bailey e López de Prado), così provare molte varianti non può fabbricare un risultato.
Risultati.
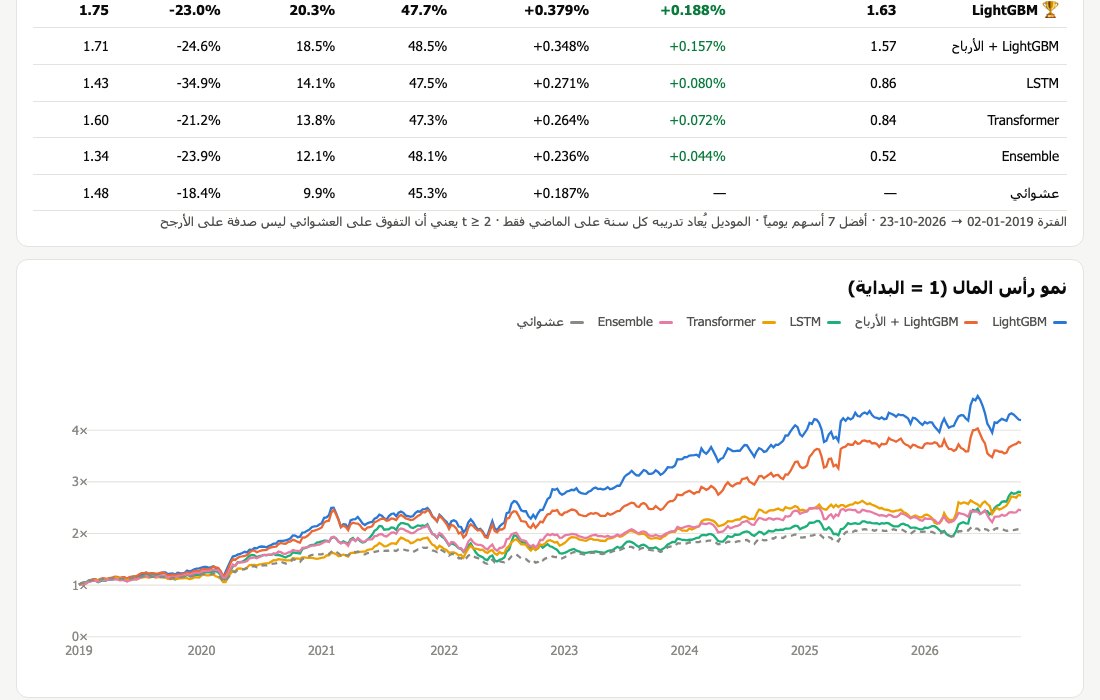
| Modello | t contro casuale | Extra / trade | Aspettativa | Percentuale vincente | Profit factor | CAGR | Drawdown massimo | Sharpe |
|---|---|---|---|---|---|---|---|---|
| LightGBM 🏆 | 1.63 | +0.188% | +0.379% | 47.7% | 1.21 | 20.3% | -23.0% | 1.75 |
| LightGBM + utili | 1.57 | +0.157% | +0.348% | 48.5% | 1.2 | 18.5% | -24.6% | 1.71 |
| LSTM | 0.86 | +0.080% | +0.271% | 47.5% | 1.15 | 14.1% | -34.9% | 1.43 |
| Transformer | 0.84 | +0.072% | +0.264% | 47.3% | 1.17 | 13.8% | -21.2% | 1.6 |
| Ensemble | 0.52 | +0.044% | +0.236% | 48.1% | 1.15 | 12.1% | -23.9% | 1.34 |
| 7 scelte casuali | – | – | +0.187% | 45.3% | – | 9.9% | -18.4% | 1.48 |
Meglio del caso su ogni riga, non ancora dimostrato
Le scelte del campione hanno reso lo +0,188% in più per trade rispetto al titolo medio e hanno circa raddoppiato la crescita del portafoglio casuale (20,3% contro 9,9% l'anno), con uno Sharpe più alto. Ma t = 1,63 è sotto il 2,0 richiesto dalla regola, e il vantaggio si è ridotto nel 2025 e nel 2026. Per questo l'arena lo considera non dimostrato, e anch'io.
Comprare QQQ era difficile da battere
Nello studio v1 (dal 2019-01-02 al 2026-09-30), tenere semplicemente QQQ ha reso il 23,1% l'anno con un drawdown del -35,1%. Il campione cresce un po' meno con un drawdown molto più piccolo (-23,0%). Una percentuale vincente sotto il 50% è normale qui: i target sono due volte più lontani degli stop.
Il ciclo giornaliero.
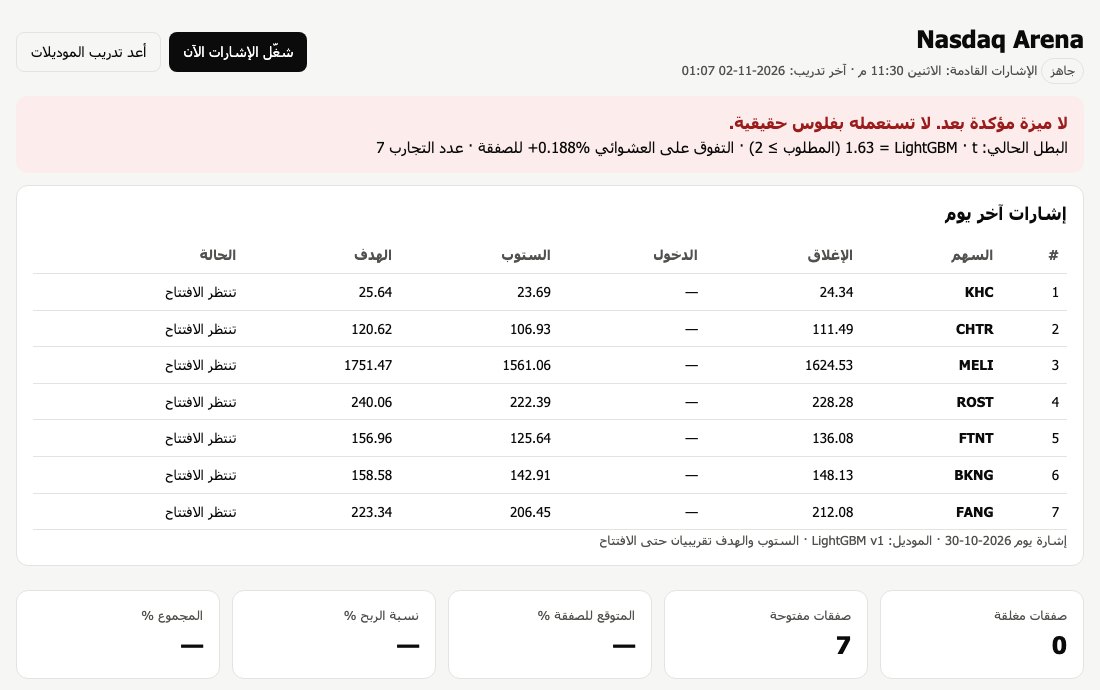
- 117:30 New York, dal lunedì al venerdìScarica prezzi e utili del giorno, chiude i trade simulati che hanno toccato stop, target o il quinto giorno, e pubblica i risultati con il totale progressivo.
- 2Punteggio e sceltaCarica il campione salvato, assegna un punteggio a ogni ticker sulla chiusura di oggi e tiene i 7 migliori con livelli di stop e target dall'ATR di ciascun titolo.
- 3Pubblicare con il verdettoScrive i segnali nel registro prima dell'apertura e li invia su Telegram con il nome del modello e il verdetto attuale. L'invio su Telegram è collegato; finché non viene impostato il token del bot, i messaggi vanno nel log.
- 4Sabato 10:00Aggiorna tutti i dati, ripete l'intera arena walk-forward, incorona un campione secondo la regola e riaddestra ogni modello su tutto lo storico per la settimana successiva.
Architettura.
Approfondimenti tecnici.
1. Battere il mercato è il test sbagliato
- Problema
- In un mercato rialzista quasi ogni strategia solo long sembra buona. Scegliere ogni giorno 7 titoli del Nasdaq a caso con gli stessi stop ha reso qui il 9,9% l'anno.
- Approccio
- L'arena misura ogni modello contro scelte casuali tra gli stessi titoli negli stessi giorni: il rendimento extra giornaliero delle sue 7 scelte rispetto alla media di tutti i titoli, come t-statistica corretta per i trade di 5 giorni sovrapposti. Così si isola l'abilità di scelta dalla direzione del mercato.
- Trade-off
- Un modello può guadagnare e fallire comunque il test. È proprio questo il punto.
2. Il leakage è la norma, quindi è escluso per progetto
- Problema
- I dati azionari giornalieri lasciano filtrare il futuro in modi silenziosi: etichette che finiscono dopo l'inizio del test, utili datati all'annuncio invece che al primo giorno negoziabile, righe mescolate nel tempo.
- Approccio
- Le variabili usano solo ciò che è noto alla chiusura del giorno t. Le etichette sono esiti di trade triple-barrier dall'apertura successiva. Il training si ferma 12 giorni prima di ogni anno di test. Gli utili dopo la chiusura contano dalla seduta successiva. Le sequenze per le reti neurali sono costruite per singolo titolo con padding a zero, mai tra ticker diversi.
- Trade-off
- Riaddestrare ogni anno si adatta più lentamente che ogni trimestre; lo studio v1 riaddestrava ogni trimestre senza un guadagno che valesse il calcolo.
3. Deep learning su un portatile, senza fingere
- Problema
- LSTM e Transformer sono la risposta di moda per i prezzi. Su un M1 Pro devono essere piccoli per addestrarsi dentro un job settimanale.
- Approccio
- Entrambe le reti vedono 20 giorni × 13 input normalizzati, si addestrano per 4 epoche in batch da 4.096 sul backend Metal (MPS) di Apple, con seed fissi per esecuzioni ripetibili. Entrano nella stessa arena degli alberi, con la stessa regola.
- Trade-off
- Hanno perso contro il gradient boosting su questi dati: t = 0,86 e 0,84 contro 1,63. Le variabili tabellari giornaliere favoriscono gli alberi.
4. Un server che lavora mentre dormo
- Problema
- I segnali servono solo se arrivano ogni sera e i modelli vengono riaddestrati ogni settimana, anche quando il Mac era chiuso all'ora prevista.
- Approccio
- Un'app FastAPI con APScheduler in ora di New York (così l'ora legale USA è gestita): il job giornaliero dal lunedì al venerdì alle 17:30 chiude i trade simulati conclusi e pubblica i 7 del giorno dopo; il job di riaddestramento del sabato aggiorna prezzi e utili, ripete l'arena e riaddestra ogni modello. I job saltati partono al risveglio entro 6 ore. launchd tiene vivo il server.
- Trade-off
- I dati di mercato arrivano da Yahoo Finance, che elimina i ticker delistati senza avviso; il job lo registra e prosegue.
5. Trade simulati, registrati come quelli veri
- Problema
- Un backtest è una storia raccontata dopo. L'unico storico onesto è quello scritto prima del risultato.
- Approccio
- Ogni segnale viene aggiunto a un registro prima dell'apertura del mercato: ticker, punteggio, ATR e chiusura di riferimento. Le esecuzioni successive registrano l'entrata all'apertura, lo stop e il target, poi lo chiudono su stop, target o quinto giorno, al netto dei costi. I messaggi precisano che il punteggio ordina i titoli e non è una probabilità di vincita.
- Trade-off
- Il registro è partito il 30 ottobre 2026; servono mesi prima che significhi qualcosa.
6. Dire “non dimostrato” sulla dashboard
- Problema
- Gli strumenti di trading mostrano in verde il backtest migliore. Gli utenti lo leggono come una promessa.
- Approccio
- La dashboard e il messaggio dei segnali riportano il verdetto dell'arena: finché la t-statistica del campione è sotto 2, un banner rosso dice che non c'è un vantaggio confermato e che i segnali non vanno usati con denaro reale. Il verdetto viene dallo stesso JSON che legge la classifica, quindi non può discostarsi dai numeri.
- Trade-off
- Rende il prodotto più debole in uno screenshot, e più affidabile in una conversazione.
Cosa ho imparato.
Il semplice ha battuto il sofisticato
Un filtro di meta-labelling sopra il primo modello, il miglioramento da manuale, ha ridotto la crescita annua dal 17,1% all'8,8% nello studio v1. La media dei quattro modelli è stata la voce più debole dell'arena (t = 0,52).
Qui gli alberi battono le sequenze
Sulle variabili tabellari giornaliere, LightGBM ha battuto nettamente entrambe le reti neurali, e aggiungere il drift degli utili non ha battuto LightGBM semplice nel complesso, anche se ha fatto meglio nel 2024 e nel 2025.
Prossimi passi
Un universo senza survivorship bias con gli ex membri dell'indice, mesi di trade simulati prima di qualsiasi affermazione, variabili di settore e di regime di mercato, e l'attivazione del canale Telegram quando il registro avrà qualcosa di onesto da mostrare.