
Un closer AI che risponde ai miei messaggi Telegram come farei io, e sa quando tacere.
Panoramica.
Trader che chiedono prima di pagare
Spirex vende analisi di trading con AI a trader di lingua araba. Prima di pagare chiedono di piani, pagamento con carta o USDT, analisi gratuite e se è una truffa, di solito in pochi messaggi brevi, un vocale o lo screenshot di una ricevuta.
Un fondatore, ogni fuso orario
I contatti che aspettano ore si raffreddano. Un bot classico risponde a “ok” e agli sticker, inventa prezzi, manda il wallet sbagliato e promette percentuali di vincita che il marchio si rifiuta di promettere.
Un assistente con giudizio
Risponde come il fondatore, in dialetto saudita o nella lingua del cliente, tace quando il silenzio è giusto, passa soldi e rabbia a una persona e ricontatta i clienti che non rispondono più, entro limiti rigidi scritti nel codice.
Come decide.
- 1Aspetta che il cliente smetta di scrivereI messaggi vengono raccolti per chat. Gli eventi di scrittura e di registrazione vocale contano come attività, così una raffica di cinque messaggi riceve una risposta, non cinque. L'attesa è configurabile e ha un limite, quindi nessuno aspetta a lungo.
- 2Legge l'intera conversazioneGli ultimi 40 messaggi con i nuovi evidenziati, una breve nota di memoria su questo cliente e ogni foto (una ricevuta, un grafico) o vocale nei nuovi messaggi, inviati al modello come audio e immagini.
- 3Una chiamata a Gemini decideGemini su Vertex AI restituisce JSON rigoroso secondo uno schema: rispondere, tacere o passare la mano, la fase di vendita, la lingua del cliente, al massimo due messaggi, un motivo privato per me e una nota di memoria aggiornata.
- 4Il codice controlla la risposta prima che partaQualsiasi indirizzo USDT diverso dal wallet reale, o qualsiasi promessa numerica di vincita, trasforma la risposta in un passaggio a me. Dai messaggi vengono tolti i simboli che una persona non digita mai al telefono.
- 5Scrive come una persona, poi inviaLa chat viene segnata come letta, l'indicatore “sta scrivendo” dura in proporzione al testo e partono al massimo due messaggi. In modalità bozza la risposta arriva prima a me.
La sala di controllo.
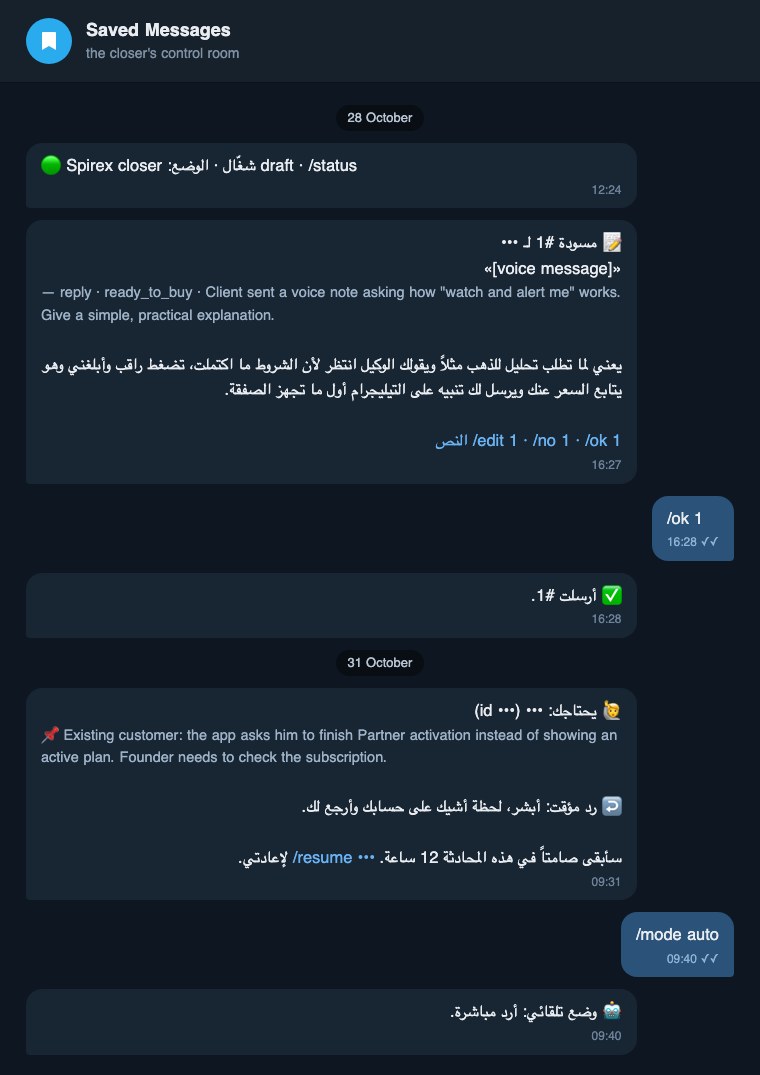
Nessuna dashboard da aprire: il closer mi scrive dove sono già. Bozze, passaggi ed errori arrivano come messaggi; i comandi tornano nello stesso modo.
/ok 3 · /no 3 · /edit 3
Invia, scarta o riscrivi una bozza prima che arrivi al cliente.
/mode draft · /mode auto
Approvi ogni risposta, oppure lo lasci rispondere direttamente.
/pause · /resume · /status
Lo fermi, lo riavvii, o vedi le risposte dell'ultima ora e le bozze in attesa.
/mute @user · /resume id
Lo tieni fuori da una chat, o lo fai rientrare dopo un passaggio.
Decisioni reali.
Il cliente ha mandato solo uno sticker, senza testo né domanda. Il playbook dice di ignorare gli sticker isolati.
Il cliente ha mandato un vocale chiedendo come funziona “osserva e avvisami”. Spiegarlo in modo semplice, in dialetto saudita.
Il cliente ha perso soldi con la vecchia versione e chiede se la nuova garantisce di non perdere. Essere onesti: nessuno strumento elimina le perdite; l'agente fissa lo stop prima dell'entrata e dice di aspettare quando il setup non è chiaro. Invitarlo a una prova gratuita.
Il cliente voleva opzioni binarie. Spirex è fatto per trade spot e CFD con entrata, stop e target, quindi dirlo onestamente, non forzare la vendita e lasciare la porta aperta.
Cliente esistente: l'app gli chiede di completare l'attivazione Partner invece di mostrare un piano attivo. Il fondatore deve controllare l'abbonamento.
Un affiliato chiede un mese gratuito per promuovere Spirex nelle dirette. Le decisioni su partnership e piani gratuiti spettano al titolare.
Regole di sicurezza.
Blocco del wallet
Ogni indirizzo Tron in una bozza viene confrontato con l'unico wallet reale. Un indirizzo diverso blocca la risposta e mi avvisa.
Nessuna promessa di vincita
Un'espressione regolare intercetta promesse numeriche di percentuale di vincita, precisione e “senza rischio” in arabo e in inglese. Le smentite oneste come “non esiste un profitto garantito” passano comunque.
Mai per primo
Risponde solo a chi ha scritto. I follow-up vanno solo alle chat in cui il cliente ha già scritto e il nostro ultimo messaggio è rimasto senza risposta.
Chi ignora
Bot, account verificati e ufficiali, contatti salvati in rubrica (amici e famiglia), utenti silenziati e ogni chat che sto gestendo a mano.
Limiti di frequenza
Le risposte hanno un tetto per chat e per ora. Quando si raggiunge il tetto, la chat non viene segnata come gestita, così il recupero successivo le risponde.
Silenzio dopo il passaggio
Dopo un passaggio resta fuori da quella chat per un tempo stabilito, o finché non invio /resume con l'id della chat.
Architettura.
Approfondimenti tecnici.
1. Una risposta per raffica, non per messaggio
- Problema
- Su Telegram le persone mandano una domanda in quattro pezzi. Un bot che risponde a ogni pezzo sembra un bot e si ripete.
- Approccio
- Ogni chat ha un buffer in attesa e un solo task in attesa. Nuovi messaggi ed eventi di scrittura spostano la scadenza; il task parte dopo un periodo di quiete o un limite massimo, poi passa tutti gli id dei messaggi raccolti a una sola decisione. Al modello viene chiesto di coprire tutto in un'unica risposta.
- Trade-off
- Una risposta arriva qualche secondo dopo rispetto a un bot istantaneo, che è anche come si comporta una persona.
2. “Tacere” è una risposta valida
- Problema
- La maggior parte dei risponditori automatici risponde a tutto: “ok”, un pollice in su, un link spam, una chat personale.
- Approccio
- Tacere e passare la mano sono valori dello stesso enum di rispondere nello schema della risposta, con accanto la fase di vendita. Il playbook elenca quando tacere; il log mostra che lo fa, dagli sticker isolati al panico fuori tema su un exchange violato.
- Trade-off
- Un silenzio sbagliato lascia un cliente senza risposta, quindi i silenzi possono essere inviati ai Messaggi salvati mentre costruisco fiducia.
3. Regole nel codice, non solo nel prompt
- Problema
- Un prompt può essere ignorato. In una chat di pagamenti, un indirizzo di wallet inventato o un “90% di vincite” sono una perdita reale o una promessa tradita.
- Approccio
- guard() gira dopo ogni risposta del modello: il controllo del wallet, il pattern sulle percentuali di vincita e un umanizzatore che toglie trattini, barre, virgolette e marcatori di elenco lasciando intatti i link. Una bozza bloccata non arriva mai al cliente; io ricevo la bozza e il motivo.
- Trade-off
- Il pattern sulle percentuali di vincita è volutamente stretto, così le frasi oneste che parlano di profitto non vengono bloccate.
4. La fiducia si guadagna in modalità bozza
- Problema
- Affidare la propria casella di vendita a un modello dal primo giorno è un azzardo.
- Approccio
- Parte in modalità bozza: ogni risposta proposta arriva nei miei Messaggi salvati con motivo e fase, e rispondo /ok 3, /no 3 o /edit 3 con il mio testo. /mode auto lo attiva. Se scrivo io in una chat, il mio messaggio viene distinto dai suoi invii e lui si fa da parte.
- Trade-off
- La modalità bozza è più lenta; serve per i primi giorni, non per sempre.
5. Non perdere mai un messaggio
- Problema
- Il closer gira su un MacBook. I coperchi si chiudono, il Wi-Fi cade e Telegram non sempre invia ogni aggiornamento.
- Approccio
- Ogni due minuti un passaggio di recupero cerca le chat private in cui l'ultimo messaggio è del cliente, delle ultime tre ore, più recente di quanto già gestito, e le mette in coda. launchd lo avvia al login e lo riavvia se va in crash, dentro caffeinate così il Mac resta sveglio mentre gira.
- Trade-off
- Se il Mac è del tutto spento, i clienti aspettano finché non si riaccende.
6. Follow-up con educazione
- Problema
- I contatti spariscono dopo il prezzo. Una persona ricontatterebbe una o due volte; uno spammer all'infinito.
- Approccio
- Ogni dieci minuti cerca le chat in cui l'ultimo messaggio era nostro, 3 ore e poi 24 ore prima. Il modello decide se un promemoria è opportuno e scrive un breve messaggio che finisce con una domanda. Solo di giorno, ora saudita, al massimo 20 all'ora, mai a fasi come not_interested, spam o già pagato.
- Trade-off
- Al massimo due promemoria; un contatto che vuole più attenzione la riceve da me.
7. Una conoscenza che chiunque può modificare
- Problema
- Prezzi e regole cambiano ogni settimana. Cambiarli non dovrebbe significare cambiare codice.
- Approccio
- A ogni chiamata il modello legge quattro file Markdown: prodotto, prezzi e passaggi di pagamento; una mappa delle obiezioni (valore, fiducia, sforzo, tempo, identità, rischio) adattata dal metodo open source objection-destroyer; il playbook sul tono e sulla chiusura; e le FAQ sul trading automatico. I fatti che non sono nei file non esistono: il modello passa la mano invece di indovinare.
- Trade-off
- Circa 30 KB di contesto per chiamata, che un modello Flash gestisce a basso costo.
8. Una chiamata al modello che fallisce in sicurezza
- Problema
- Le API limitano le richieste, i modelli cambiano nome e il credito finisce, sempre nel momento peggiore.
- Approccio
- Le chiamate vanno all'endpoint di Vertex AI con una catena di modelli alternativi. Gli errori 429 e 5xx riprovano con attesa crescente, da 400 a 404 si passa al modello successivo, 402 (credito esaurito) si ferma subito, e una risposta JSON troncata viene ripetuta. Se tutto fallisce, al cliente non arriva nulla e io ricevo un messaggio.
- Trade-off
- Solo la libreria standard di Python per l'HTTP, quindi nulla da rompere negli aggiornamenti.
Prossimi passi.
Cosa sistemerei per primo
Gira su un portatile, quindi un Mac spento significa risposte più lente; il suo posto è un piccolo server sempre acceso. Il file di sessione di Telegram dà pieno accesso all'account e va protetto come un segreto, non come un file. Le risposte sono contate ma non ancora collegate ai pagamenti, quindi non posso ancora dire quante vendite abbia chiuso.
Roadmap
Incrociare le chat chiuse con gli account paganti (lo scanner in sola lettura Spirex Reach ordina già la casella così), costruire un set di valutazione da conversazioni passate per testare le modifiche al prompt prima che vadano in produzione, e riusare lo stesso cervello per i messaggi WhatsApp e Instagram.