Abbiamo aggiunto l’intelligenza artificiale, e la bolletta cresce più del fatturato
Perché una funzione di IA diventa cara così in fretta, e come misuro i consumi nei miei prodotti: limiti controllati sul server prima della chiamata, crediti come freno, un prezzo per ogni chiamata, budget che si fermano e il modello giusto per ogni lavoro.
 Reda Bellassery·
·8 min di lettura
Punti chiave
- Una funzione di IA diventa cara perché ogni chiamata ha un prezzo, e a decidere quante chiamate fare è l’utente, non tu.
- Un limite che esiste solo nell’app non è un limite. È il server che deve controllare quanto può spendere l’account prima di chiamare il modello.
- In Spirex le monete sono il freno: il consumo viene misurato sul server e scalato prima della chiamata al modello, così una funzione costosa non supera mai quello che l’account ha pagato.
- In VYNORO ogni chiamata all’IA viene registrata con modello, token, costo stimato e tempo di risposta, e ogni missione parte con un budget di 1 USD che si ferma finché il titolare non dice di continuare.
- Usa il modello più potente solo dove il ragionamento conta, uno più veloce per i passaggi di routine, e nessun modello per ciò che il codice sa calcolare da solo.
Hai aggiunto una funzione di intelligenza artificiale al tuo prodotto. Ai clienti piace. Ad alcuni piace moltissimo.
Poi arriva la fattura di OpenAI o di Google, ed è più alta del mese scorso. Anche il fatturato è salito, ma meno. Nessuno sa dirti quali clienti l’hanno fatta crescere, né quanto sarà il mese prossimo.
Conosco bene il problema. Gestisco un’app di IA con più di 28.900 utenti registrati e una voce in tempo reale che costa a ogni secondo di chiamata. Se non avessi misurato i consumi fin dall’inizio, oggi sarebbe la bolletta a gestire l’attività, non io.
Questo articolo è per titolari di PMI e fondatori che hanno una funzione di IA nel loro prodotto, o stanno per aggiungerla, e vogliono un costo che si possa prevedere.
Perché una funzione di IA diventa cara così in fretta?
Perché ogni chiamata all’IA ha un prezzo, e a decidere quante chiamate fare è l’utente. Una normale pagina web non ti costa quasi nulla a ogni visita. Una risposta dell’IA, un minuto di voce o l’analisi di un’immagine costano soldi veri, ogni volta.
Fin qui nulla di grave. I guai iniziano con alcune abitudini che ritrovo spesso nelle funzioni di IA:
- Il limite sta nell’app. Il pulsante sparisce dopo dieci utilizzi, ma il server risponderebbe volentieri anche all’undicesimo. Chi chiama il server direttamente non ha limiti.
- Il consumo si conta dopo la chiamata. Quando scopri che l’account aveva superato la quota, i soldi sono già spesi.
- Le prove gratuite si sfruttano facilmente. Un nuovo indirizzo email vale una nuova prova, e così una persona usa la funzione “gratis” per sempre.
- Nessuno registra il costo di ogni chiamata. Vedi un solo totale in fattura e non sai quale funzione, piano o cliente l’ha generato.
- Un solo modello per tutto. Il modello più caro scrive un suggerimento di una riga che uno più economico scriverebbe altrettanto bene.
Nessuno di questi è un difetto che noti in una demo. Lo noti in fattura, qualche settimana dopo il lancio.
Cosa vuol dire misurare i consumi dell’IA?
Misurare i consumi dell’IA è contare e limitare quanto ogni account può spendere prima che il modello venga chiamato, e registrare quanto è costata davvero ogni chiamata. È come il contatore della luce, con una differenza: deve dire di no prima che la corrente passi, non mandarti la bolletta dopo.
In pratica si riduce a quattro regole:
È il server a decidere se questo account può usare questa funzione adesso. L’app si limita a mostrare la risposta.
Quale modello, quanti token, quanto è costata, quanto è durata. Senza questi dati vai a intuito.
Un lavoro o una sessione ha un tetto. Arrivati lì, si mette in pausa e chiede, invece di spendere in silenzio.
La quarta regola è scegliere il modello giusto per ogni lavoro. Ci torno più avanti.
Come ho misurato i consumi in Spirex: le monete sono il freno
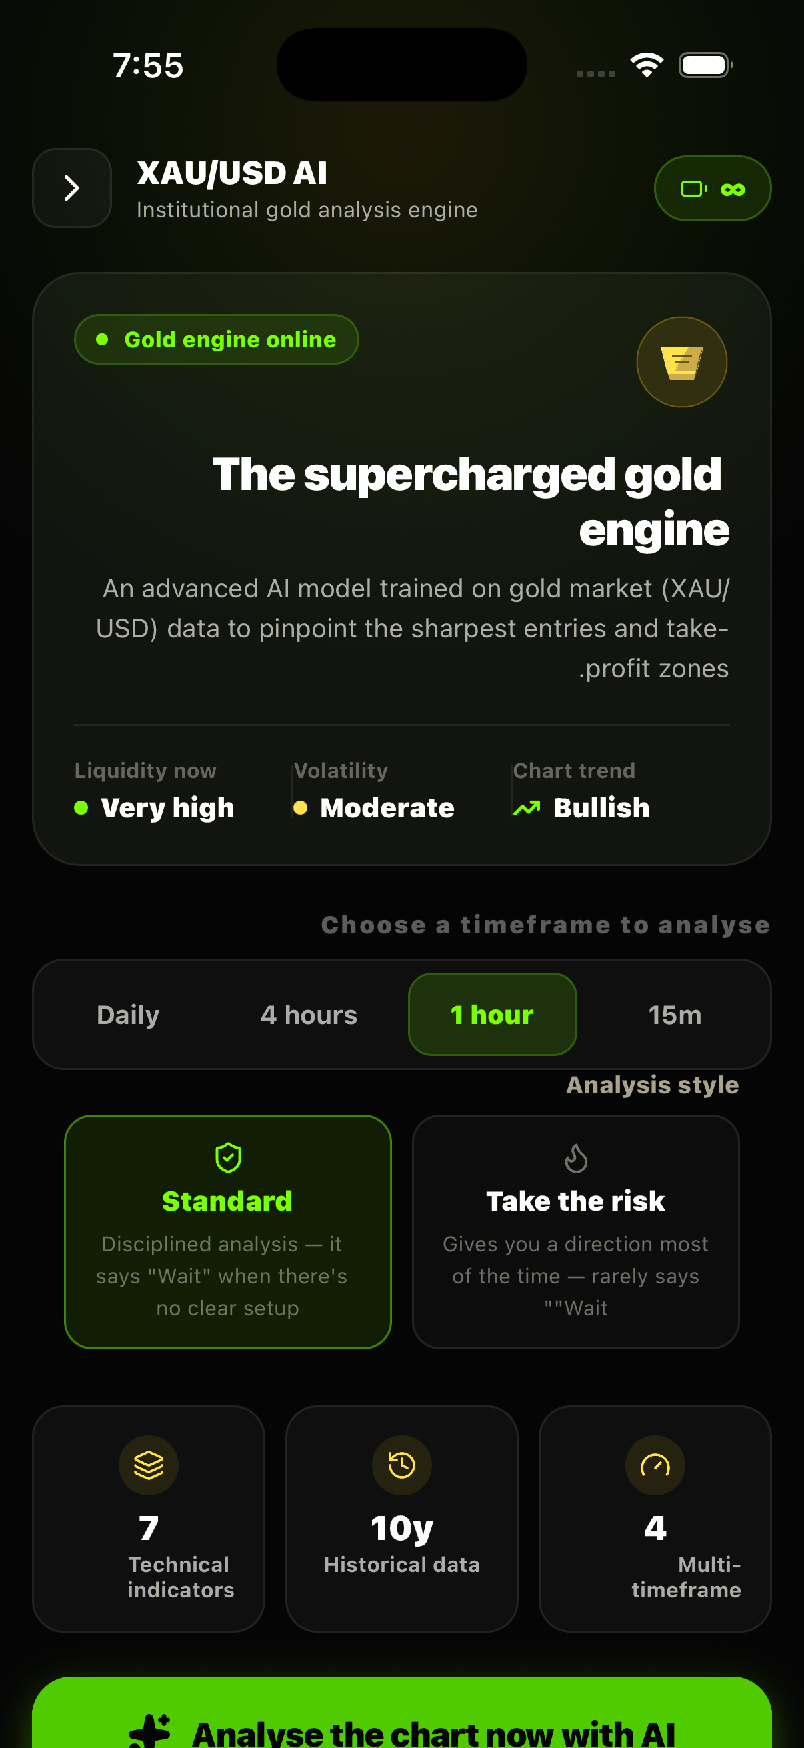
Spirex è una mia app: un analista di trading basato sull’IA, pensato prima di tutto per chi parla arabo, pubblicato su Google Play e con più di 28.900 utenti registrati. Offre su richiesta tre cose costose: analisi di trading con GPT-4o, lettura degli screenshot dei grafici con GPT-4o vision e una chiamata vocale in tempo reale con un analista IA.
Ognuna ha un costo per chiamata che un utente motivato moltiplicherebbe volentieri per mille. Per questo le monete di Spirex non servono solo a guadagnare. Sono il freno ai consumi.
- Scalate prima della chiamata. Il consumo viene misurato sul server e scalato prima di chiamare il modello, così una funzione costosa non supera mai quello che l’account ha pagato.
- Due monete, due compiti. Le monete d’argento pagano le analisi normali. Le monete d’oro sbloccano le funzioni premium e sono illimitate dal piano PRO in su.
- Corretto quando qualcosa si rompe. Se un’analisi fallisce per un motivo tecnico, la moneta viene restituita in automatico.
- Limiti per piano, su entrambi i lati. Limiti di analisi orari, limiti di chat giornalieri e un tetto di caratteri per messaggio valgono sia nell’app sia sul server.
- Solo il server concede. I diritti di accesso vengono scritti solo sul server. Niente nell’app può assegnarsi un piano da solo.
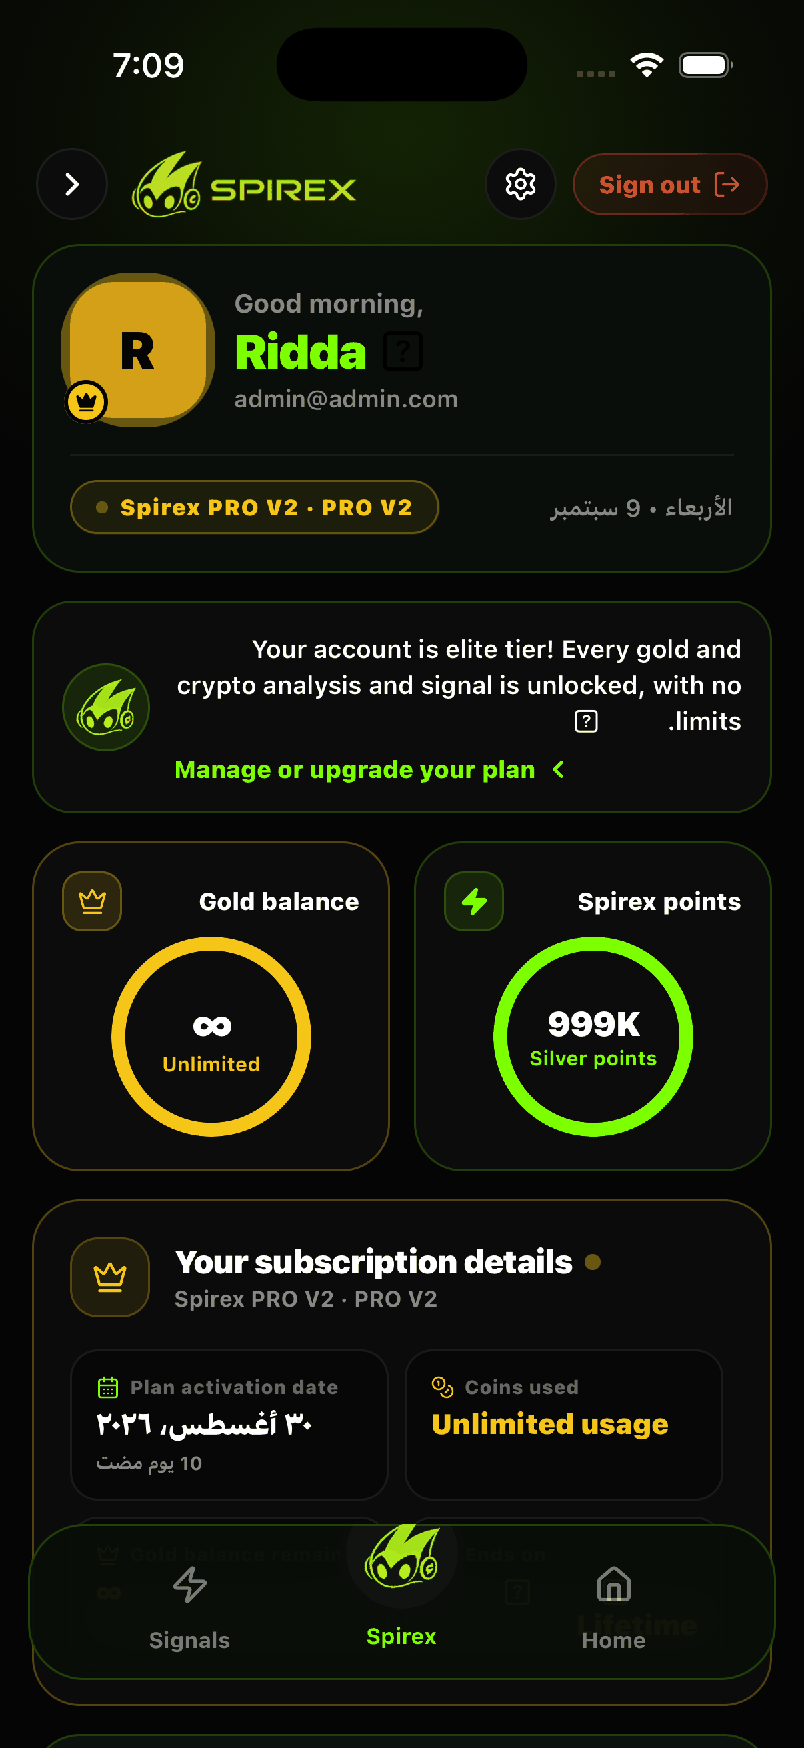
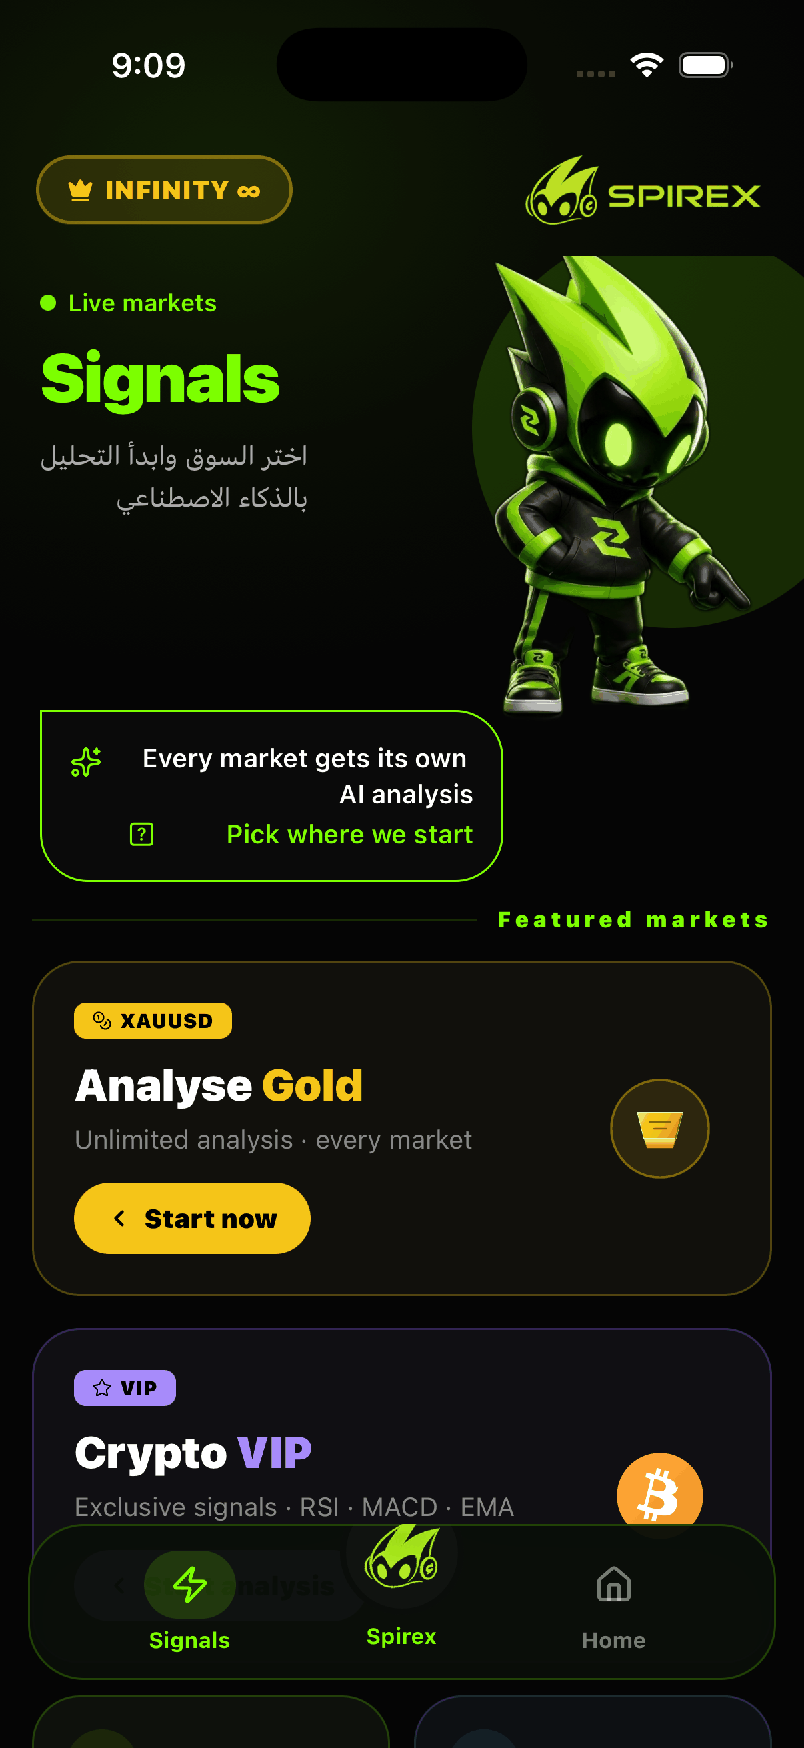
Un dettaglio che mi piace: il tetto di caratteri vale per ogni messaggio della cronologia, non solo per quello nuovo. Così si blocca anche un trucco silenzioso: inviare una cronologia finta e lunghissima per far costare di più ogni chiamata.
Un altro: non tutto ha bisogno del modello. L’indicatore dell’umore del mercato nella schermata iniziale si calcola dai prezzi in tempo reale, senza spendere un credito di analisi. Anche gli indicatori tecnici si calcolano sul server, così il modello riceve fatti, non dati grezzi.
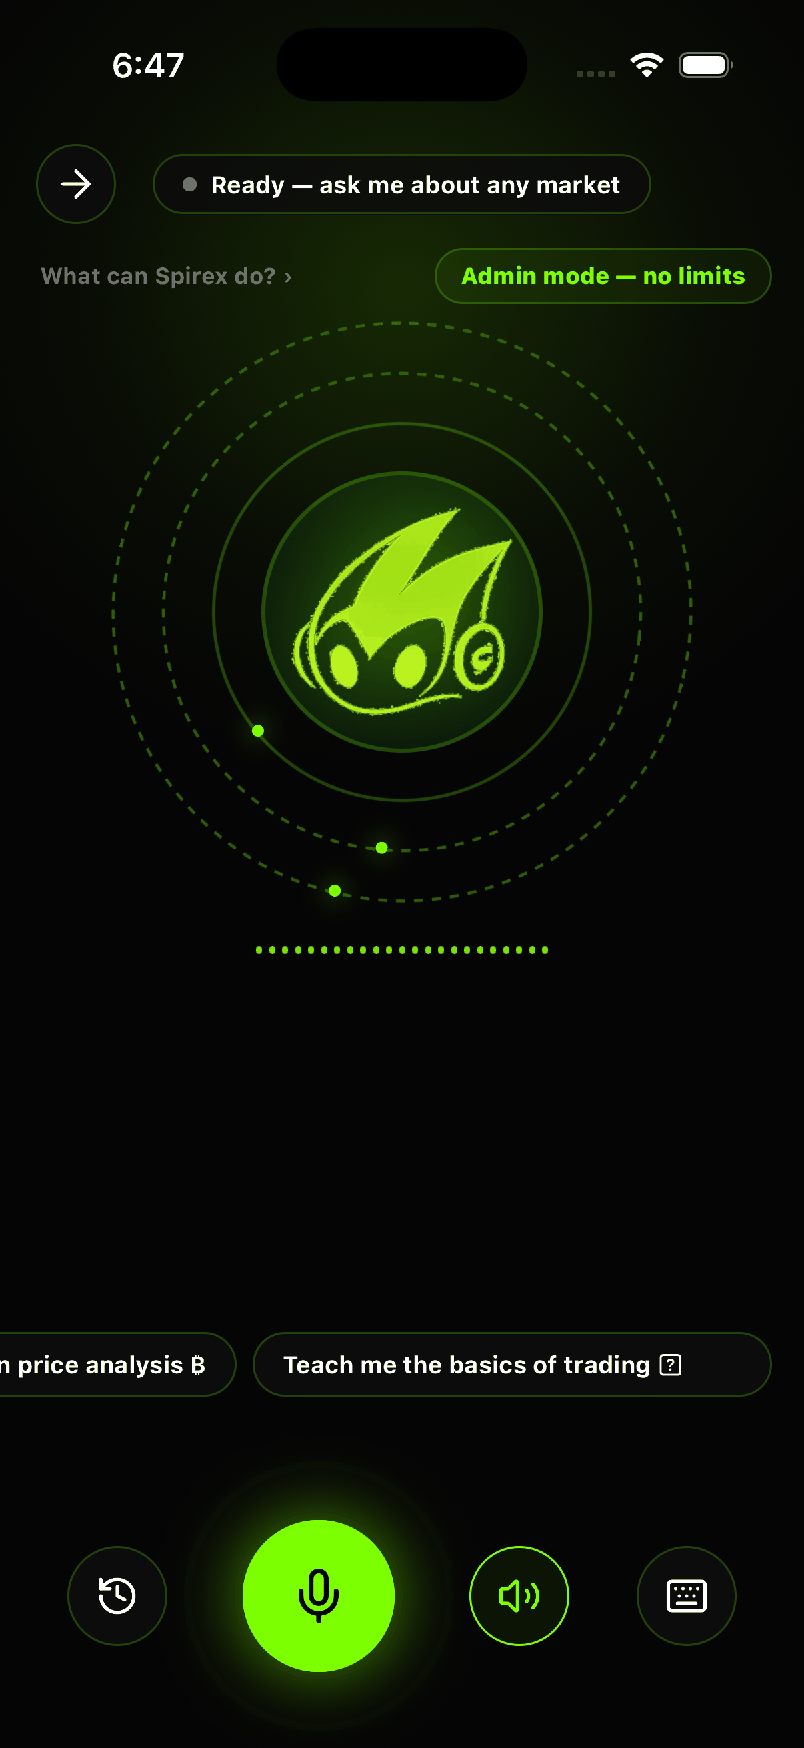
La funzione più cara: la voce in tempo reale
In Spirex la voce in tempo reale costa circa 0,126 dollari al minuto, e la prova gratuita si poteva sfruttare all’infinito creando nuovi account. Con la voce, misurare i consumi non è più facoltativo.
Ecco cosa fa il server:
- Una prova a persona, non ad account.Il registro delle prove usa insieme l’identificativo del telefono e l’email, quindi una nuova email sullo stesso telefono non fa ripartire la prova.
- Il server controlla, poi apre la linea.Il diritto alla chiamata si decide sul server in base all’abbonamento reale, mai in base a quello che dichiara l’app. Solo allora crea una chiave OpenAI Realtime di breve durata per quella chiamata.
- Ogni sessione ha un budget in secondi.Il server fissa un limite rigido in secondi per ogni chiamata e lo comunica all’app.
- Un segnale ogni 30 secondi.Il consumo viene registrato mentre la chiamata è in corso, così chiudere l’app di forza non aggira il contatore.
La chat testuale segue la stessa idea con una leva più economica: va su GPT-4o o GPT-4o-mini a seconda del piano, con un limite di messaggi al giorno.
O misuri l’IA, o è l’IA a misurare te.
Come VYNORO dà un prezzo a ogni chiamata
VYNORO, il mio team di IA per piccole agenzie, ha un rischio diverso. Gli agenti che lavorano in ciclo con i loro strumenti possono bruciare soldi senza farsi notare, e una piccola agenzia ha bisogno di un costo prevedibile.
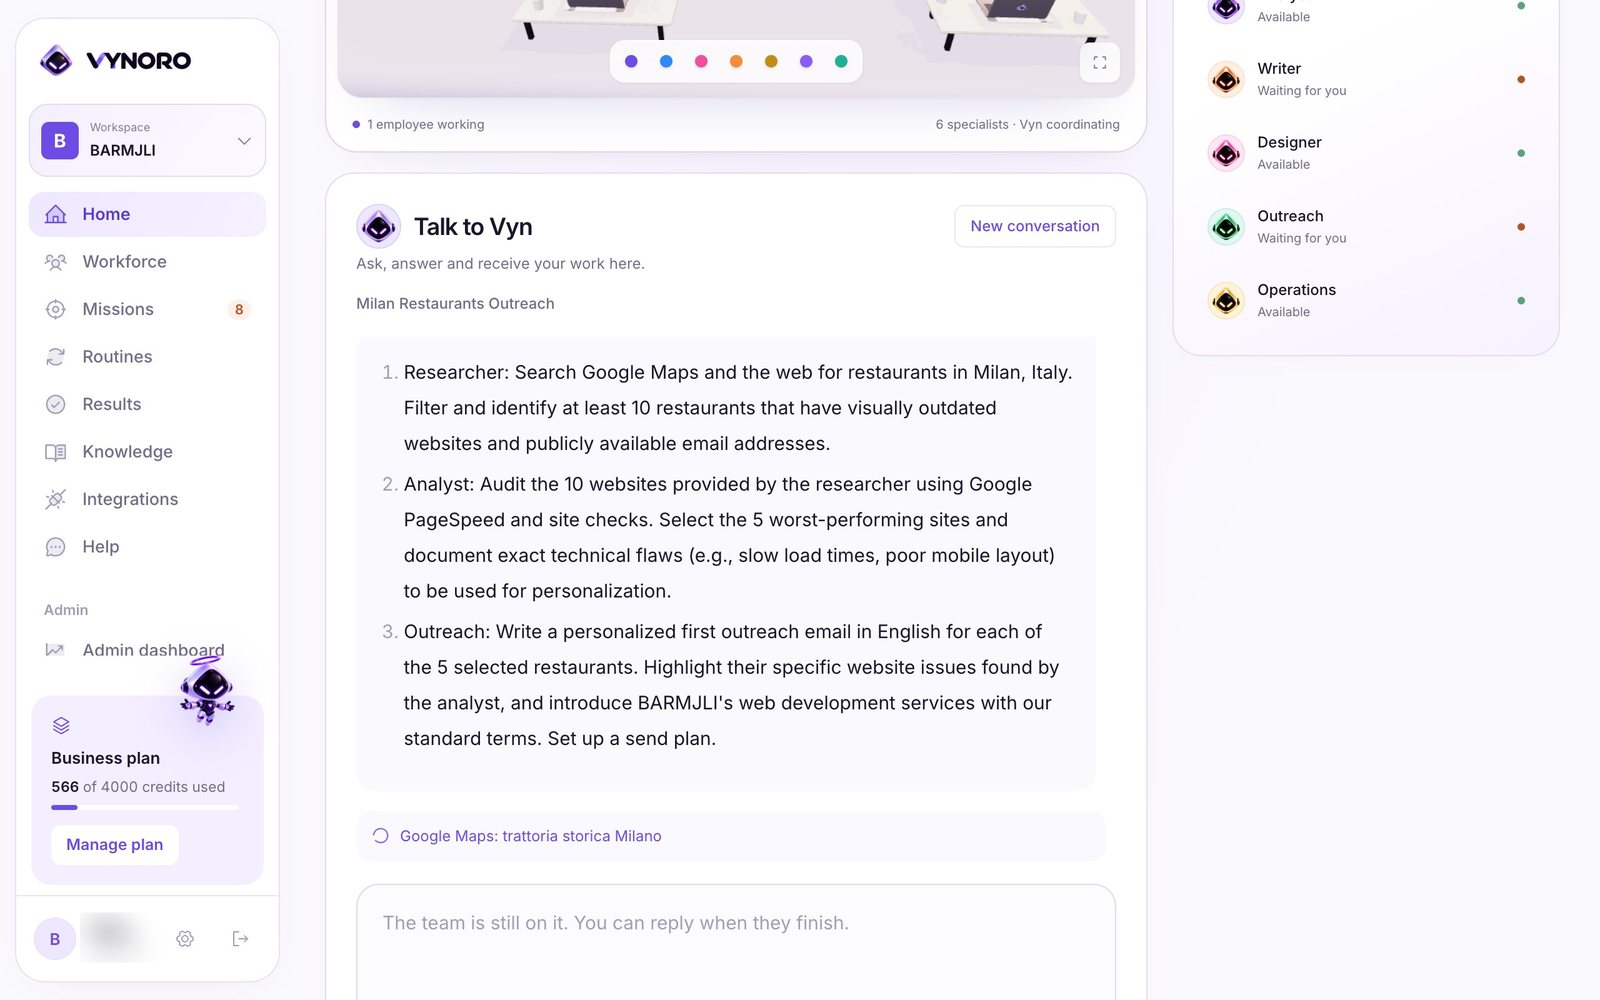
- Ogni chiamata viene registrata. Ogni chiamata a Gemini viene salvata con modello, token, costo stimato e tempo di risposta.
- Ogni missione ha un budget. Una missione parte con un budget di 1 USD. Al limite si mette in pausa finché il titolare non dice di continuare.
- Limiti del piano sul server. Piani e crediti si controllano sul server prima che una missione parta, non solo nell’interfaccia.
- Le domande veloci restano economiche. Una domanda o un testo breve riceve una risposta diretta, senza avviare una missione.
- Il codice controlla prima dell’IA. Email inventate e numeri senza fonte vengono trovati dal codice e rimandati indietro per una riscrittura, senza una chiamata all’IA per scovarli.
Ho raccontato come è costruito in un articolo dedicato.
Quale modello di IA per quale lavoro?
Usa il modello più potente solo dove il ragionamento conta, e uno più veloce ed economico per tutto il resto. In VYNORO il modello per ogni livello si sceglie in un unico file. Pro fa la pianificazione e le revisioni di Vyn, Flash lavora per gli specialisti e Flash-Lite è la riserva veloce, ognuno con nuovi tentativi e tempi massimi. In Spirex i suggerimenti brevi girano su GPT-4o-mini.
Un modo semplice per decidere:
| Il lavoro | Cosa uso | Perché |
|---|---|---|
| Pianificare, rivedere, risposte su cui le persone agiscono | Il modello più potente | Una risposta sbagliata qui costa più dei token |
| Passaggi di routine: riassunti, bozze, estrazione dati | Un modello intermedio e veloce | Va bene così, e costa molto meno a chiamata |
| Suggerimenti brevi, etichette, riserve | Il modello più piccolo | Conta più la velocità della profondità |
| Calcoli, conteggi, verifiche, indicatori | Nessun modello: il codice | Esatto, istantaneo e gratuito |
L’ultima riga è quella che fa risparmiare di più. Per esempio, Spirex calcola gli indicatori tecnici con il codice e chiede al modello solo di ragionare sul risultato.
Quanto ti costa misurare i consumi?
Un po’ di lavoro in più e un po’ di attrito. Secondo me ne vale la pena, ma ecco i compromessi onesti, presi dal mio codice:
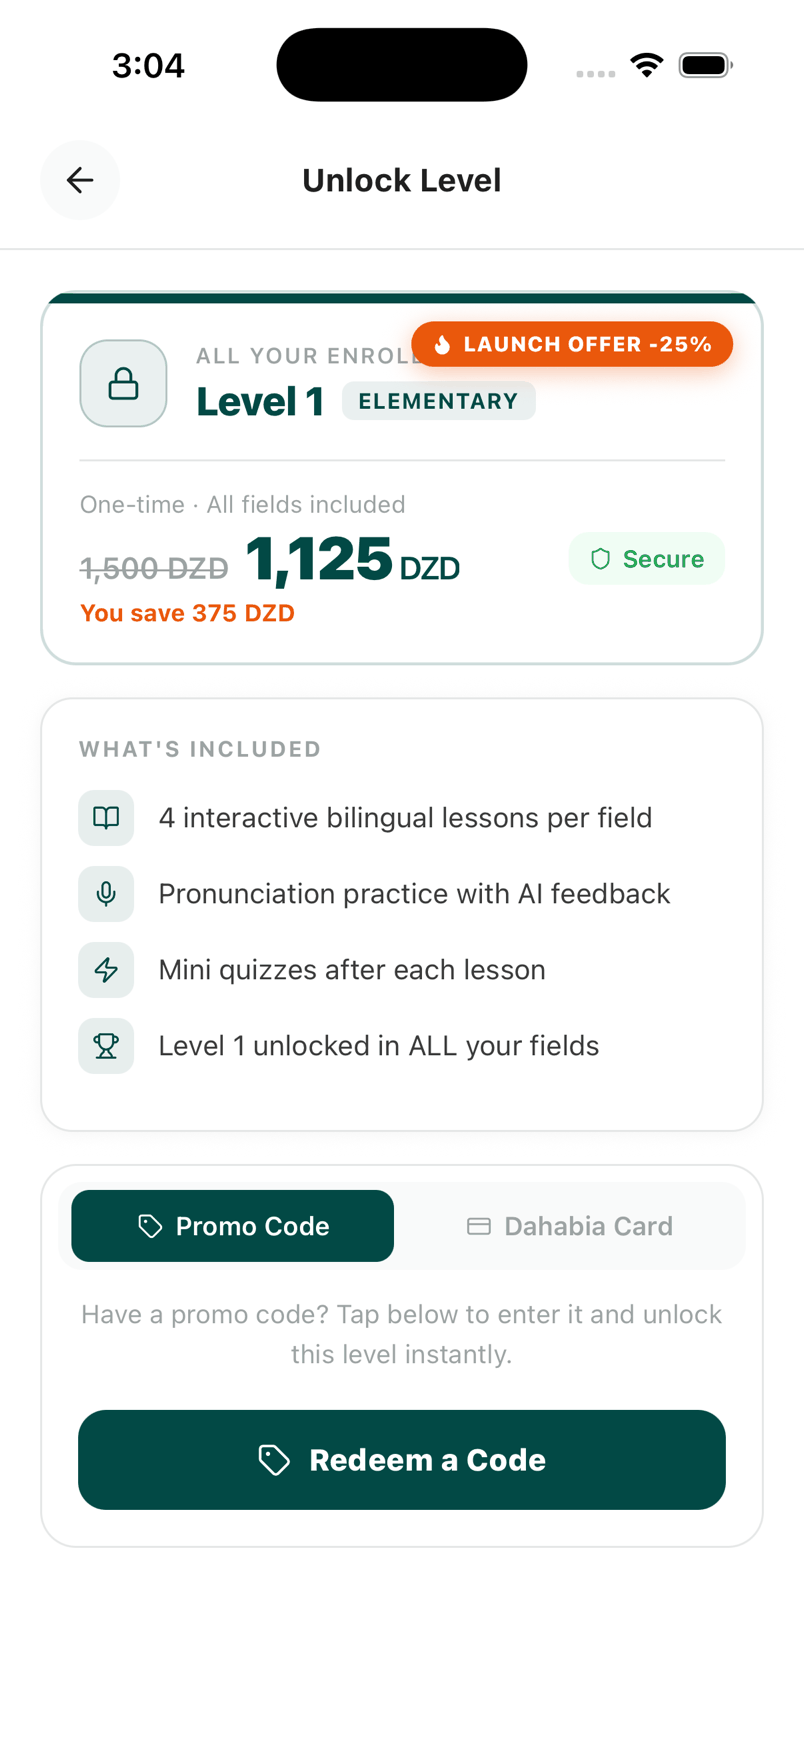
- I limiti possono colpire le persone sbagliate. Spirex ha sedici codici di abbonamento accumulati nelle varie versioni. Un controllo del piano fatto in modo ingenuo una volta ha dato un limite pari a zero a 58 utenti PRO paganti. Oggi un unico livello di mappatura decide il piano, ma gli elenchi dei piani vivono sia nell’app sia sul server e vanno tenuti allineati a mano.
- Una stima non è una fattura. VYNORO stima il costo dal numero di token. Segue da vicino la fattura del fornitore, ma non è la fattura.
- L’antiabuso ha dei buchi. Su iOS l’identificativo del telefono cambia dopo una disinstallazione completa. L’ho accettato, e la parte email del registro delle prove copre il resto.
- I budget interrompono. Una missione in pausa aspetta il titolare. È voluto, ma è comunque un clic che qualcuno deve fare.
Una checklist da usare questa settimana
Chiedi al tuo sviluppatore, o verifica tu, se la tua funzione di IA fa queste cose:
- Le chiamate all’IA passano dal tuo server. La chiave dell’IA resta lì, mai nell’app, così i controlli qui sotto non si possono aggirare.
- Il consumo si controlla prima della chiamata. A rifiutare è il server, non solo il pulsante.
- Il consumo si scala prima della chiamata, e si restituisce se la chiamata fallisce per un motivo tecnico.
- Ogni chiamata viene registrata con modello, token, costo e account che l’ha fatta.
- Lavori e sessioni lunghe hanno un budget che mette in pausa o ferma tutto al limite.
- Le prove gratuite non dipendono solo dall’email.
- Ogni passaggio usa il modello più economico che lo fa bene, e i calcoli li fa il codice.
- I limiti del piano vivono sul server, così una vecchia versione dell’app o una richiesta diretta ricevono la stessa risposta.
Se la tua app è stata creata in fretta con uno strumento di IA, il primo punto è spesso quello che salta. Ne parlo, insieme ad altri problemi simili, in come sistemare un’app creata con l’IA prima di andare in produzione. I limiti dei piani sono lo stesso problema in un’altra forma, e li ho trattati in piani, ruoli e limiti. E i crediti funzionano solo se il pagamento che li concede viene verificato sul server, come spiego in pagamento ricevuto, accesso mancante.
Cosa fare adesso
Se la bolletta dell’IA cresce e non sai perché, parti dal registro. Una settimana di costi per chiamata, per funzione e per account di solito mostra dove vanno i soldi. Poi aggiungi il controllo sul server e il budget dove fa più male.
Aggiungere l’IA a un prodotto esistente con limiti di consumo, così il costo resta prevedibile, è uno dei servizi che offro. Trovi tutta la parte tecnica nel caso studio di Spirex e nel caso studio di VYNORO. Se vuoi che dia un’occhiata alla tua situazione, scrivimi cosa hai costruito e quale funzione ti preoccupa. Puoi scrivermi in italiano o in inglese.
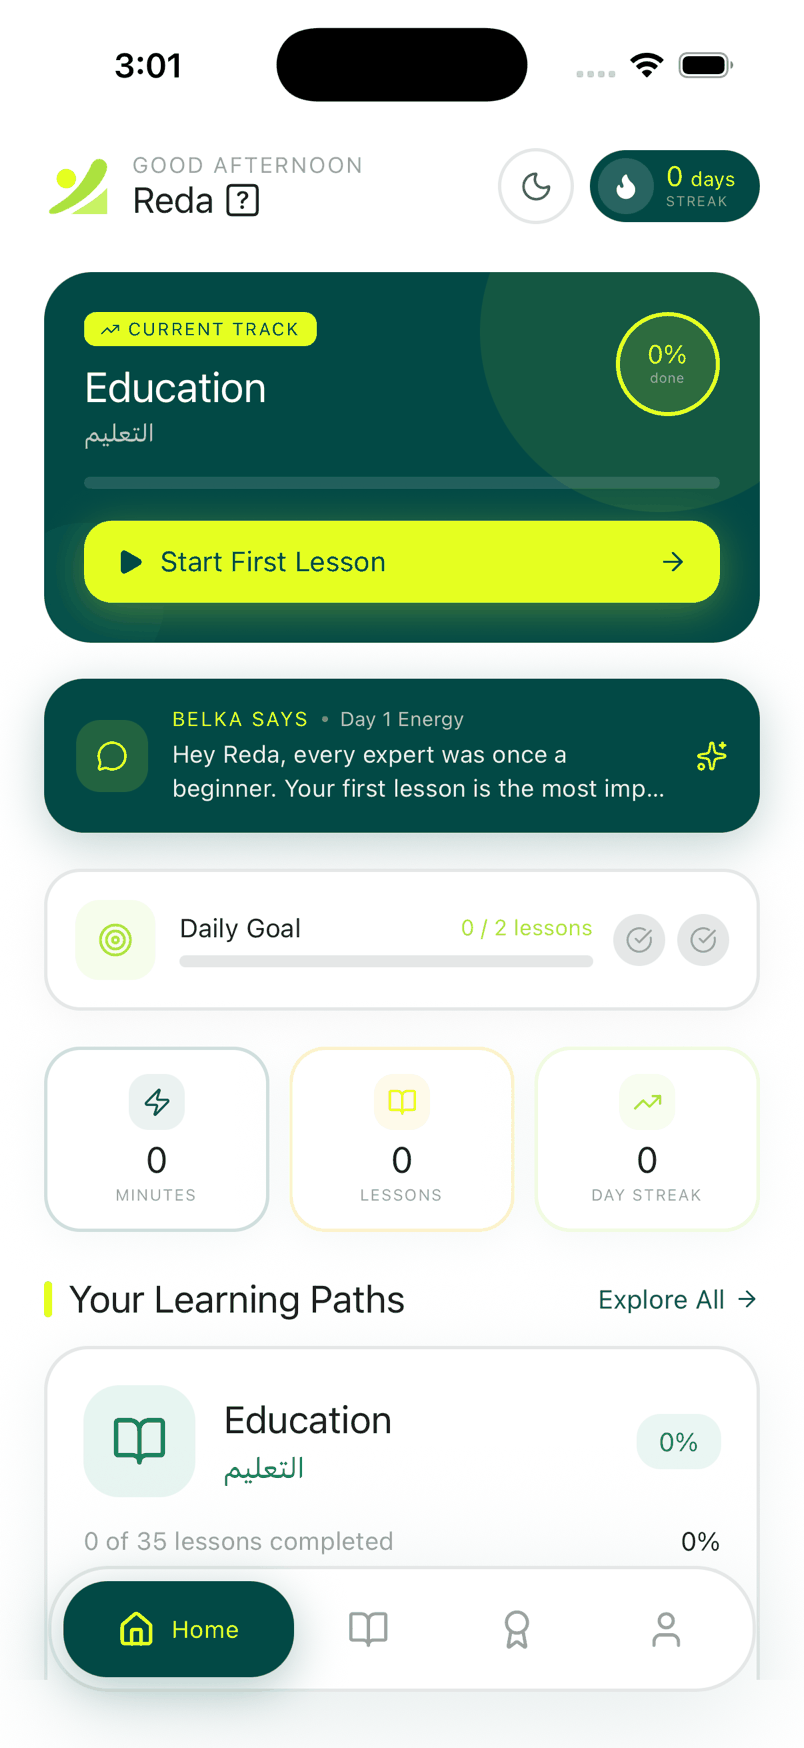
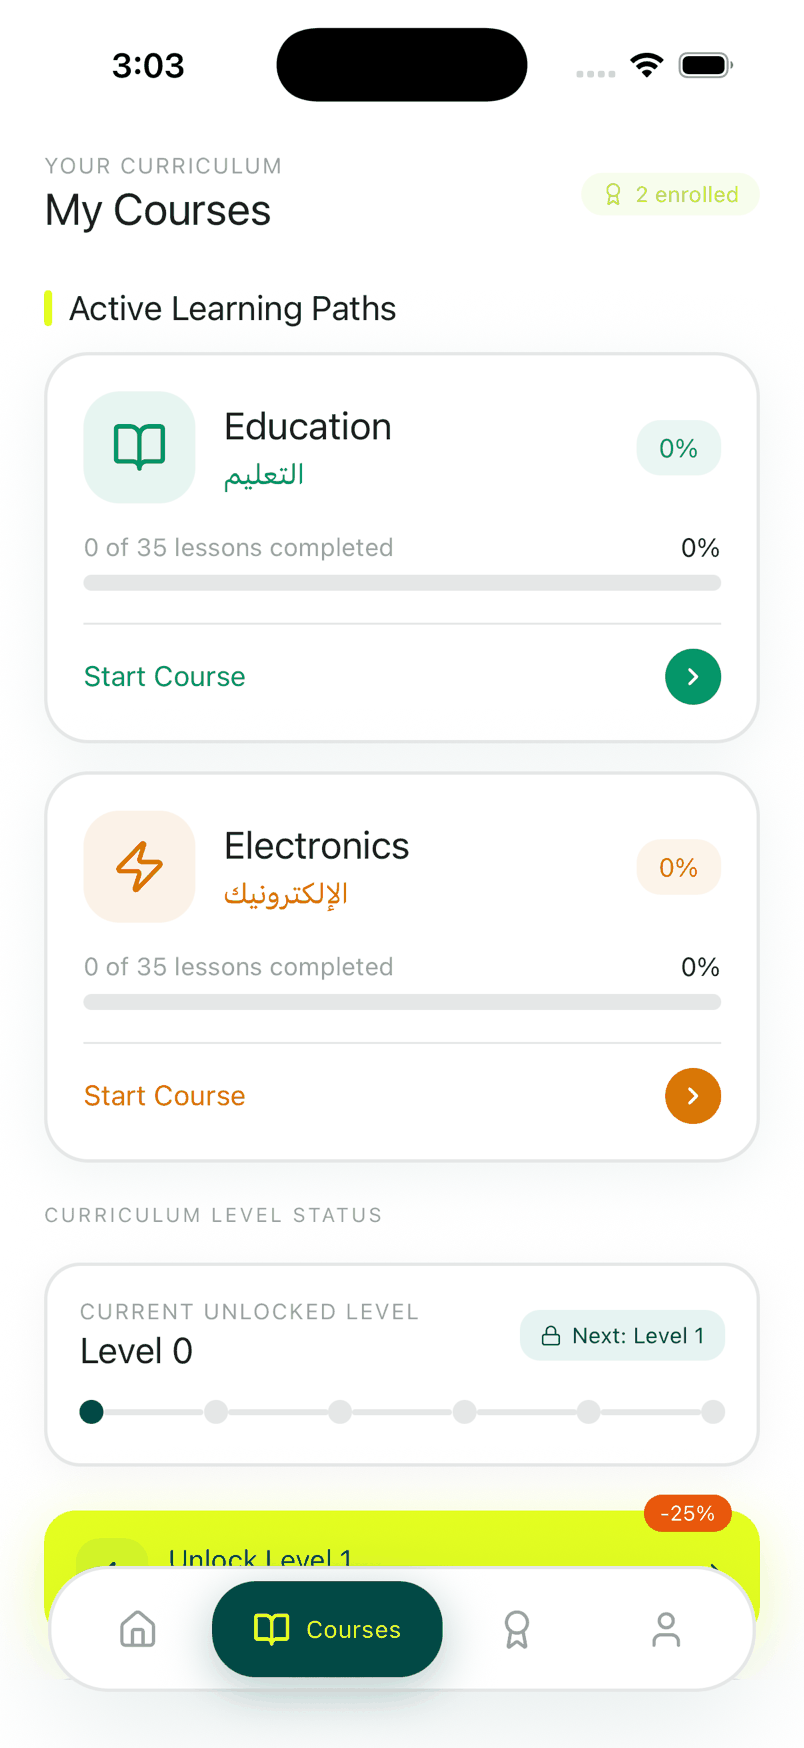
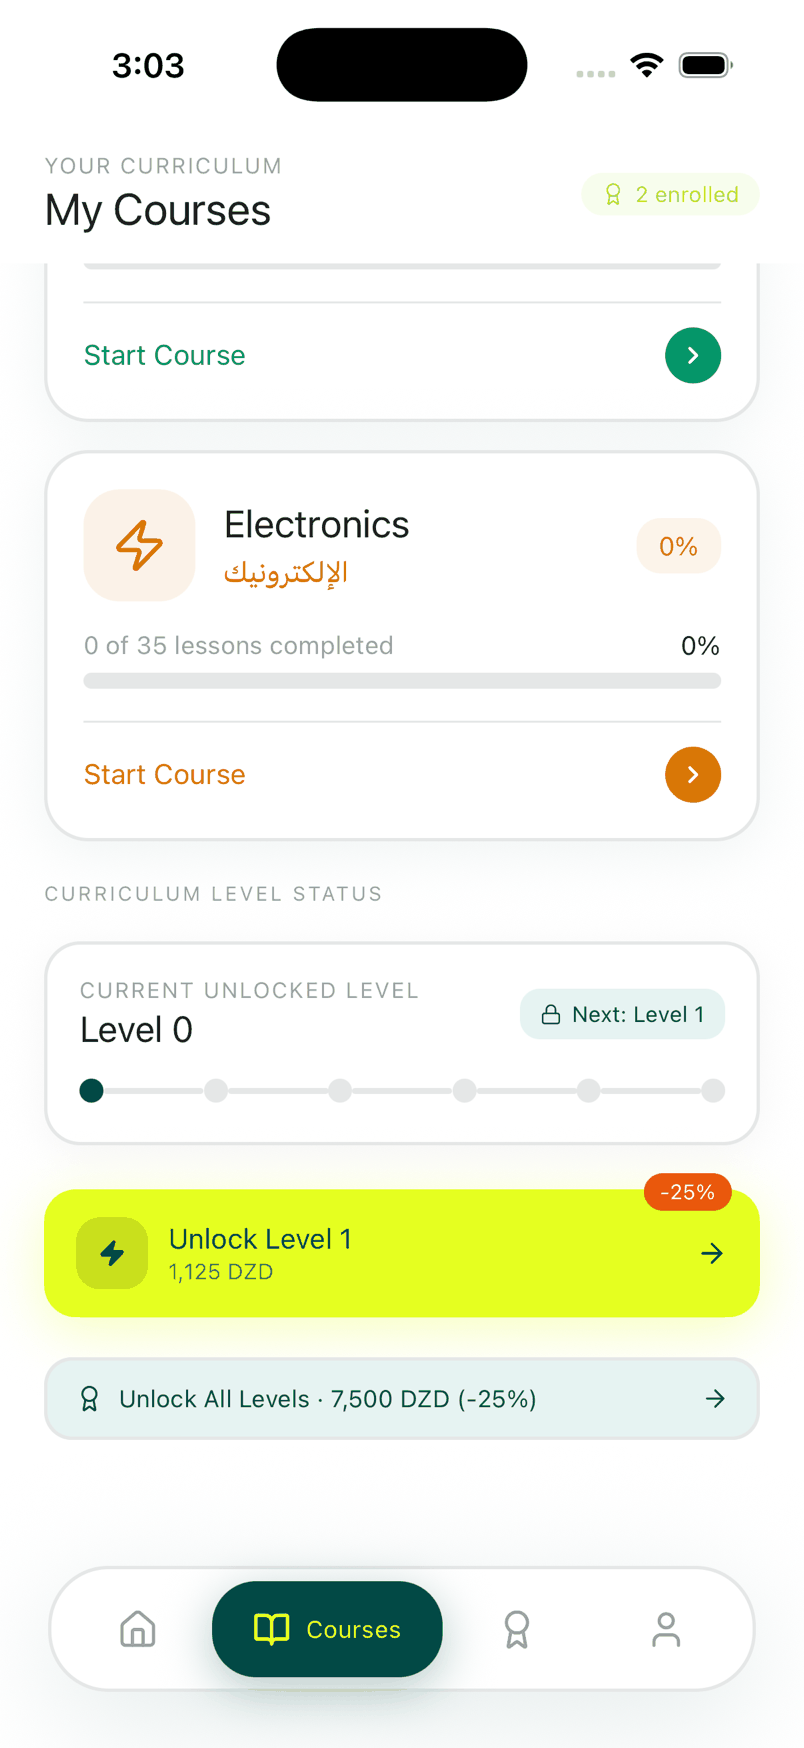
Sulle immagini: le schermate del telefono vengono da Spirex, la mia app su Google Play. La schermata di VYNORO viene dallo spazio di lavoro della mia agenzia, Barmjli, durante una missione reale su dati pubblici.
Domande frequenti
Perché la bolletta di OpenAI o Gemini cresce più del mio fatturato?
Che cosa significa misurare i consumi dell’IA?
Servono per forza crediti o monete per controllare i costi?
Conviene usare il modello di IA più economico?
Si possono aggiungere limiti di costo a una funzione di IA già online?
Sviluppo agenti IA, applicazioni web e app mobile per le aziende e gestisco la mia agenzia, Barmjli. Qui scrivo di quello che costruisco e di cosa mi ha insegnato.